投稿

AWS PythonのLambda関数でS3のファイル読み書き
イメージ
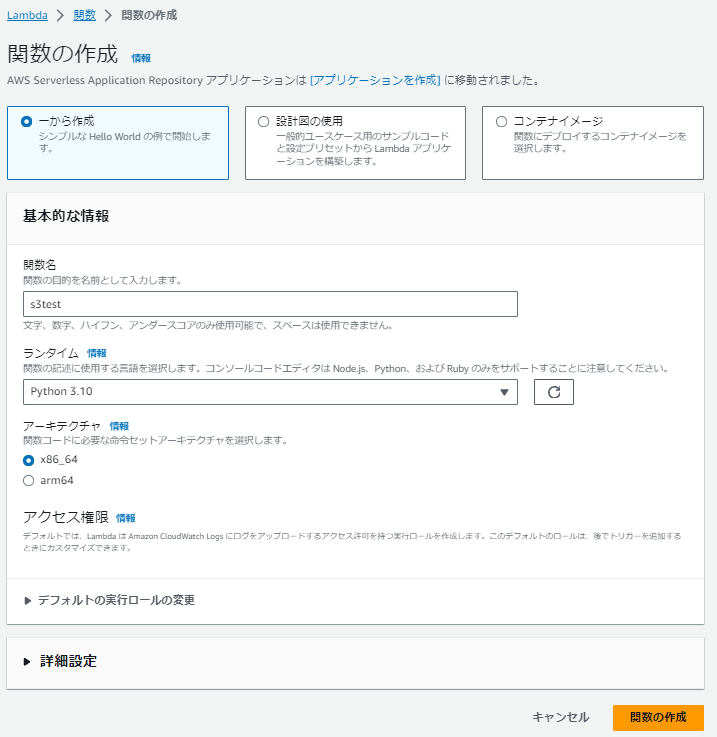
 PythonのLambda関数で「/tmp」に保存しているファイルは毎日削除されてしまうことを知り、S3に退避させる必要があったのでやってみた。 とりあえずS3にテスト用のバケットを作成して適当なjsonファイルをアップロードしておく Lambdaでテスト用の関数を作成する まずはアップロードしてあるファイルを取得するためのコードを書く AWSをPythonから操作するためのライブラリとしてboto3を利用する import boto3 boto3.resourceは無くなるわけではないが開発を止めるみたいな記事があったので boto3.clientを使います。 お作法がちょっと違うだけでできることは同じだと思う。 boto3.clientを使ったjsonファイルの取得 s3 = boto3 . client ( "s3" ) response = s3 .get_object( Bucket = "testdata" , Key = "test.json" ) body = response [ "Body" ].read() Bucketにバケット名 Keyにファイル名 responseのBodyにファイルの内容が入っているのでそれを取得します ファイルのまま取得するのであれば s3 .download_file( Bucket = "testdata" , Key = "test.json" , Filename = "/tmp/test.json" ) これだけですね。 今回のテストデータが50MBくらいあったのですが 取得に3秒くらいかかってる・・・ 思ったより遅い test.json→test.zipにしてみて取得後解凍するようにしてみたけど 解凍に時間かかってトータルそこまで変わらなかった・・・ boto3.resourceを使ったファイルの取得 s3 = boto3 . resource ( "s3" ) obj = s3 .Object( "testdata" , "test.json" ) response...

X(Twitter)への自動投稿

 X(Twitter)に投稿でもしないと誰も「 まちあてル 」に気づかない。。。 ということでそういう処理を追加 やり方はどこにでも書いてあるので躓くことはなかったが API v1.1とAPI v2の違いに最初気づかずなぜ書き方が違うのか迷ってた。 X(Twitter)の開発者ポータルでアプリ登録する際の APIの利用目的を書くのが大変(そんなに深く考えてないわ) GAEのクーロンスケジュールで実行するのでそれ以外のアクセスは除外 if request . headers . get ( "X-Appengine-Cron" ) is None :     return render_template ( "404.html" ), 404 X(Twitter)アプリ登録で発行されたキーをセット consumer_key = "ABCDEFG" consumer_secret = " ABCDEFG " access_token = " ABCDEFG " access_token_secret = " ABCDEFG " client = tweepy . Client (     consumer_key = consumer_key ,     consumer_secret = consumer_secret ,     access_token = access_token ,     access_token_secret = access_token_secret ) で、送信 client . create_tweet ( text = "ほげほげ " ) GAEでクーロンスケジュールを作成するために cron.yaml cron : - description : "tweet from cron"   target : default   url : /cron   schedule : every day 08:10 として、毎日17:10に投稿されるように定義 gcloud app deploy cron.yaml実行 してクーロンスケジュ...

Google App Engineへのデプロイ

 Google App Engineへのデプロイ 「GAE Flask デプロイ」でググった結果、いろいろなやり方が見つかった。 Pythonのバージョンとか結構古い記事だったり、なんかうまくいかないのがあったが 最終的にはGAEのリファレンスを見ながらやってみる。 1.Google Cloud CLIをインストール   Google Cloud CLI インストーラ をダウンロード 2.Google Cloud Consoleでプロジェクトを作成  プロジェクトの作成はこの方法がわかりやすかったので採用 3.デプロイに関係するファイルの用意  .gcloudignore   アップロードする必要のないファイルを列挙  app.yaml   アプリの設定を記載するのだが細かい良し悪しがわからない・・・   最低限runtimeが必要とのことなので   runtime: python310   あとはサンプルを調整 4.phpでgunicornをインストール 5.gcloud init実行  Googleへのログインとか 6.gcloud app deploy実行  リージョン選べと言われたので   asia-northeast1  を選択 なんとかデプロイ成功 gcloud config configurations list で作成済みコンフィグを確認して gcloud config configurations activate hogehoge でアクティブなコンフィグを切り替えできる とかあったけど現段階では関係なかった。   

回答履歴のコピー機能

イメージ
ボタンを押したら回答履歴をコピーさせたかった javascriptで簡単にできると思ったが、めちゃくちゃ手間取った navigator . clipboard . writeText ( res ); で簡単にコピーできるはずだったのに 自分のスマホではコピーされない。なぜ?なぜ? iPhoneのsafariでは制限があるもよう・・・ 自分のスマホはiPhoneだった(結果的によかった) textareaにコピーしたい文字列をセットしてからコピー処理しないといけないらしい コピーしたい文字列はAjaxでサーバーに問い合わせたとして レスポンス返ってからの処理は $ ( '#copyText' ). show (); var el = document . getElementById ( 'copyText' ); el . value = res ; if ( navigator . userAgent . match ( /ipad | ipod | iphone/ i )) {     var oldContentEditable = el . contentEditable ,     oldReadOnly = el . readOnly ,     range = document . createRange ();           el . contentEditable = true ;     el . readOnly = false ;     range . selectNodeContents ( el );         var s = window . getSelection ();     s . removeAllRanges ();     s . addRange ( range );           el . setSelectionRange ( 0 , 999999 );   ...

回答のチェック処理

イメージ
 Wordleみたいにするのであれば 1.ひらがなで回答してもらう 2.文字ごとの正誤判定 3.結果を返す という流れが必要 回答は で、特に問題ないだろう 市か町か村がわからないと難しすぎるかと思い表記しておく 文字後の正誤判定はいまいちな処理にはなるが 答えと入力されたものをそれぞれ文字ごとの配列にして 比較する方法とする 答えを「kotae_dict」に格納 kotae_dict = {}  index = 1 for str in kotae :      kotae_dict [ index ] = str     index += 1 入力された回答を「answer_dict」に格納 answer_dict = {} index = 1 for ans in answer :     answer_dict [ index ] = { "moji" : ans }     index += 1 入力された回答の文字が答えに使われているかを先にチェック for key in answer_dict :   dic = answer_dict [ key ]     if hiragana .count( dic [ "moji" ]) > 0 :        dic [ "class" ] = "use"     else :         dic [ "class" ] = "notuse"     answer_dict [ key ] = dic まず、どこかに使われている文字なら「use」のフラグを立てて どこにも使われていない文字なら「notuse」のフラグを立てる 次に場所の一致をチェック for key in answer_dict :     dic = answer_dict [ key ]     if len ( hiragana_dict ) >...

五十音のボタンを並べる

イメージ
 入力用に五十音のボタンを並べたい htmlに書けばいいけどめんどくさいので処理を考える aiueobutton.py  とりあえず五十音の配列を作ってみる  五十音の文字列でもいいけど後で見難いからね aiueo = [ "あいうえお" ,           "かきくけこ" ,           "さしすせそ" ,           "たちつてと" ,           "なにぬねの" ,           "はひふへほ" ,           "まみむめも" ,           "やゆよ" ,           "らりるれろ" ,           "わをん" ,           "がぎぐげご" ,           "ざじずぜぞ" ,           "だぢづでど" ,           "ばびぶべぼ" ,           "ぱぴぷぺぽ" ,           "っゃゅょ" ] でこれを回して、dictionaryに必要な要素を詰めて、配列にして返すファンクションを用意する def getList ():     btn_list = []     for row in aiueo :         for character in row :     ...

WEBアプリの設計

 細かい設計をしてから作る気はない。 試行錯誤しながらやっていく。 【したいこと】 「Wordleみたいな感じで市区町村を当てるゲームにしたい」なので ・毎日1問出題される ・五十音を入力してもらって文字ごとの使用有無判定、位置判定をする ・回答履歴を残す ・回答履歴はコピーできる こんなもんか プロジェクトフォルダに static  ├images  ├scripts.js  └style.css templates  ├base.html  └index.html app.py を用意 base.html  HTMLのベース   <head>部、<body>部の共通部分を書いておく <! doctype html > < html lang = "ja" >     < head >     </ head >     < body >         {% block main %}         {% endblock %}     </ body > </ html > index.html  本体(という言い方であってるのか?) {% extends "base.html" %} {% block main %} ここに本体を書いていく {% endblock %} という理解でやっていく